
Mohammad Hijjawi · septembre 2026, mis à jour en octobre 2026 · since-cutoff sur GitHub
since-cutoff est un outil open source, utilisable en ligne de commande et comme serveur MCP,
pour les projets Python écrits avec des agents de code. scan montre où votre code utilise une
API d’une dépendance qui a changé après la date limite d’entraînement du modèle, avec pour chacune
une note tirée du diff d’API (la version épinglée face à la version de comparaison, la dernière
publiée au moins 30 jours avant la date limite) ; sync écrit les notes dans AGENTS.md ou
CLAUDE.md et les tient à jour avec votre fichier de verrouillage ; status, des hooks pre-commit
et une action GitHub vous préviennent quand elles ne le sont plus ; le serveur MCP permet à un
agent de demander ce qui a changé dans une bibliothèque avant d’écrire du code. Seul run,
facultatif, appelle un modèle : il mesure sur lesquels des changements le modèle se trompe et si
les notes l’aident. Chaque note porte une étiquette qui dit ce qui a été vérifié : énoncée à
partir du diff d’API, ou rédigée par le modèle et conservée seulement si son exemple passe le
vérificateur de types pour votre version.
# les API modifiées qu'utilise votre code, avec une note pour chacune (aucun appel au modèle, aucune clé d'API)
uvx since-cutoff scan

# écrire les notes dans AGENTS.md et les tenir à jour (aucun appel au modèle)
uvx since-cutoff sync

# facultatif : mesurer sur quels changements votre modèle se trompe, et tester les notes (appelle le modèle ;
# --with ajoute le vérificateur de types basedpyright, dont seul run a besoin)
uvx --with basedpyright since-cutoff run
pip install since-cutoff installe tout sauf le vérificateur de types de run ;
pip install "since-cutoff[run]" l’ajoute (basedpyright, avec le Node.js qu’il apporte).
Documentation en français et code source sur GitHub · PyPI · Le fonctionnement en détail (en anglais) · Dépannage (en anglais)
Ce qu’il fait, depuis la 0.6
- Avec quelle version il compare. Pour chaque dépendance, la version de comparaison est la
dernière publiée au moins 30 jours avant la date limite d’entraînement du modèle
(
--cutoff-margin JOURS;0compare à partir de la date limite elle-même, comme avant la 0.6). Un modèle connaît le moins bien les dernières semaines avant sa date limite : llama-index-core 0.13.0, qui a suppriméReActAgent.from_toolsetFunctionCallingAgent, a été publiée la veille de la date limite de Claude Sonnet 4.5, et comparer à partir de la date limite masquait ces deux suppressions ; avec la marge, un projet qui épingle la 0.14.25 et appelle les deux est averti des deux. La ligne du modèle, les rapports et le bloc de notes donnent les deux dates, les tableaux des dépendances intitulent la colonne « compared from », et le scan dit après quel jour les API ont changé : « Your code uses 2 APIs that changed after 2025-07-01, 30 days before claude-sonnet-4-5’s training cutoff (2025-07-31) ». - Où votre code utilise une API modifiée. Les imports et les appels, et depuis la 0.6 les
appels de méthodes sur des objets dont le fichier ne nomme jamais la classe : le type du
receveur est déduit des annotations de la version épinglée elle-même, si bien que
df = pd.read_csv(...)est unDataFrame,df.groupby(...).count()unDataFrameGroupBy.count, etllm.predict(q)sur unChatOpenAIleBaseChatModel.predictde langchain-core. Un changement d’une méthode héritée est repéré sous les classes publiques qui en héritent (DataFrame.fillnapourNDFrame.fillna). Un usage repéré au seul nom de la méthode est laissé de côté, sauf avec--include-name-matches, et le scan dit combien il en a laissé. - Ce que voit le diff. Les noms supprimés ou déplacés, les paramètres supprimés ou devenus
obligatoires, les passages en keyword-only ou positional-only, les nouveaux marqueurs de
dépréciation (y compris le
@deprecatedde la PEP 702 importé par un module de compatibilité) et les changements de dépendance (httpxremplacé parhttpx2). Nouveau dans la 0.6 : les paramètres supprimés derrière**kwargs: Unpack[UnTypedDict](leread_csvde pandas 3.0 reçoit ainsi ses mots-clés, et a perdudelim_whitespace,date_parser,infer_datetime_format,keep_date_coletverbose), et les noms qu’un module prend à une autre distribution avecfrom x import *(lemcp.typesde mcp vient de mcp-types, qui a renommé tous ses champs en snake_case). - Changements publics et internes. Chaque changement est public (le niveau supérieur du
paquet l’exporte, un module le nomme dans
__all__, le réexporte ou le documente) ou interne. Les décomptes donnent les changements internes à part, sous la forme « +N internal », etscan --internalles liste ; les notes ne couvrent que les API qu’utilise votre code. - Ce que disent les notes. Le remplaçant que nomme le texte de dépréciation de la
bibliothèque elle-même, dans ses propres mots, avec l’étiquette
[diff + library](httpx 0.28 : « Useproxyormountsinstead ofproxies»). Le texte est cherché là où les bibliothèques le mettent : une directive.. deprecated::, l’entrée d’un paramètre dans la docstring, un message dewarnings.warnet, pour une méthode supprimée sans texte propre, celui de sa classe (leReActAgent.from_toolsde llama-index-core : « Usellama_index.core.agent.workflow.ReActAgentinstead. »). Quand le texte n’en nomme aucun, la note renvoie au guide de migration, au changelog ou à la page des versions du paquet pour les changements depuis la version de comparaison. Les citations gardent intact le code de la bibliothèque. Les puces qui disent la même chose de plusieurs API d’un paquet sont fusionnées en une seule. Une dépendance publiée pour la première fois après la date limite, ou dans la marge qui la précède, reçoit une note[metadata]avec la date de sa première version et son résumé. - Ce qu’il signale ne pas avoir pu voir. Un module que la version épinglée livre compilé,
sans source
.pyni stub.pyi; une distribution réexportée qui n’a pas pu être téléchargée ; une classe dont une classe de base d’un autre paquet peut définir les attributs ; des sources dans une syntaxe que le Python qui exécute since-cutoff ne sait pas analyser (le stub de numpy 2.5.4 sous Python 3.10 : le paquet n’a pas pu être vérifié, et le scan nomme le Python qui le peut). Le scan, le rapport et les outils MCP le signalent, au lieu d’annoncer des suppressions qui n’en sont peut-être pas, ou aucun changement. Un métapaquet comme llama-index, sans API propre, est présenté comme tel, avec les parties vérifiées et celles qui ne l’ont pas été. Quand PyPI est injoignable, une liste de versions mise en cache il y a plus de 12 heures est utilisée, et le scan indique de quel jour elle date. - Où vont les notes. Dans AGENTS.md, CLAUDE.md ou les deux : quand les deux fichiers
existent et que CLAUDE.md n’importe pas AGENTS.md (
@AGENTS.md),syncécrit le bloc dans les deux, car Claude Code ne lit que CLAUDE.md, et Codex, Cursor et Copilot lisent AGENTS.md ; il explique comment n’en garder qu’une copie. - Pour les scripts et les agents.
since-cutoff sync --json(avec--yes,--checkou--dry-run),since-cutoff models --json, etmodels --makerspour les seules listes des éditeurs des modèles, sans passerelles ni revendeurs. Le serveur MCP a deux prompts,check_projectetbefore_upgrade. Sans--model, le modèle de Gemini CLI est lu dansGEMINI_MODELou.gemini/settings.json. - Installation, démarrage et cache. basedpyright, dont seul
runse sert, est l’extra[run]. Une installation sans extra occupait environ 73 Mo de paquets dans un environnement virtuel neuf (environ 254 Mo avec[run]), etsince-cutoff --helpdémarre en 100 ms environ (mesures faites sous Windows, avec Python 3.13).since-cutoff cache infomontre le cache par type,cache clear --sources,--diffsou--pypivide un seul type, etSINCE_CUTOFF_CACHE_MAX_MBplafonne les sources extraites (2048 par défaut).
Il ne prend toujours en charge que Python, et les notes viennent toujours d’un diff statique de deux versions : elles disent ce qui a changé, pas ce que le modèle sait. Les changements de comportement derrière une signature inchangée lui échappent.
La suite de cette page raconte l’origine du projet et présente les premières mesures, faites avec since-cutoff 0.1.0 en septembre 2026. Des mesures plus récentes (en anglais) : Ce que votre modèle n’a pas vu (36 bibliothèques, 21 modèles, aucun appel au modèle, refait avec la 0.6) et le benchmark avec un agent de code (360 sessions de Claude Code, avec les notes de la 0.4.1).
Chaque modèle de code a une date limite d’entraînement. Votre fichier de verrouillage, non. Quand une bibliothèque modifie son API publique après cette date, un modèle qui a appris l’ancienne version continue d’écrire les anciens appels, et rien dans le prompt ne lui indique le contraire.
Je voulais un chiffre plutôt qu’une anecdote : pour un vrai projet et les versions exactes des dépendances qu’il épingle, sur lesquelles le modèle se trompe-t-il, et une courte note règle-t-elle le problème ? since-cutoff est l’outil que j’ai construit pour y répondre.
Le dispositif
Le projet d’exemple (examples/agent-app)
est une petite application d’agent qui a neuf dépendances. Six sont épinglées sur les versions
actuelles (anthropic 1.8.0, openai 3.19.2, huggingface-hub 2.0.0, langchain-core 1.6.5,
langgraph 1.2.12 et pydantic 2.13.5) ; les trois autres ne le sont pas (fastapi, requests et
httpx), et l’outil utilise donc leur dernière version.
Deux modèles ont été testés : Claude Haiku 4.5 (date limite d’entraînement : février 2025) et Claude Opus 4.6 (mai 2025). Les tâches et les notes ont été rédigées par Claude Opus 4.6.
La méthode de mesure
- Ce qui a changé. Pour chaque dépendance, on prend la version de comparaison, la dernière version publiée au moins 30 jours avant la date limite d’entraînement du modèle (par défaut ; les exécutions faites avec la 0.1.0, plus bas, prenaient la plus récente publiée au plus tard à la date limite), et on compare son API publique à celle de la version épinglée, de façon statique (griffe, aucun code importé). On trouve ainsi les objets supprimés ou déplacés, les paramètres supprimés ou devenus obligatoires, les passages en paramètres nommés uniquement ou positionnels uniquement (keyword-only, positional-only) et les nouveaux marqueurs de dépréciation. Pour ce projet et la date limite de Claude Haiku 4.5, 7 des 9 dépendances ont changé ; le diff de la 0.6, qui compare à partir du 29 janvier 2025, signale 344 changements incompatibles et 48 nouvelles dépréciations dans des API publiques, et 168 changements d’API internes.
- Des tâches qui nécessitent le changement. Pour les changements les mieux classés, un rédacteur de tâches produit de courtes tâches de programmation réalistes, qui exigent la fonctionnalité modifiée sans jamais nommer l’identifiant modifié ni ce qui le remplace. Une tâche sert de sonde ; deux sont réservées (held-out).
- Des réponses sans rien à consulter. Le modèle reçoit la tâche et le numéro de la version épinglée, sans outils, sans accès au web, sans fichiers du projet.
- Une évaluation par un vérificateur de types, à deux reprises. La réponse est vérifiée avec
basedpyright par rapport à la version de comparaison (celle de l’étape 1), puis par rapport
à la version épinglée, chacune dans un environnement isolé avec ses propres dépendances.
Seules comptent les erreurs de connaissance de l’API (noms, imports et paramètres inconnus,
arguments manquants, arité), jamais les remarques liées à la rigueur du typage.
- stale : valide pour la version de comparaison, invalide pour la version épinglée
- wrong : invalide, sans que le changement de version l’explique
- deprecated : valide, mais utilise une API marquée
@deprecateddans la version épinglée
- Rédaction et test des notes. Pour chaque échec, une note d’une ligne est rédigée pour AGENTS.md. Une note rédigée par le modèle n’est conservée que si son exemple passe la vérification de types avec la version épinglée et si chaque API qu’elle recommande figure dans cet exemple ; sinon, la note est un simple constat du changement tiré du diff d’API. Le modèle répond ensuite à nouveau, cette fois aux tâches réservées, sans puis avec les notes, et les réponses sont comparées paire par paire.
Aucun code généré n’est jamais exécuté.
Résultats
Ces exécutions ont été réalisées avec since-cutoff 0.1.0, sur le seul projet décrit ci-dessus.
| Claude Haiku 4.5 | Claude Opus 4.6 | |
|---|---|---|
| date limite d’entraînement | févr. 2025 | mai 2025 |
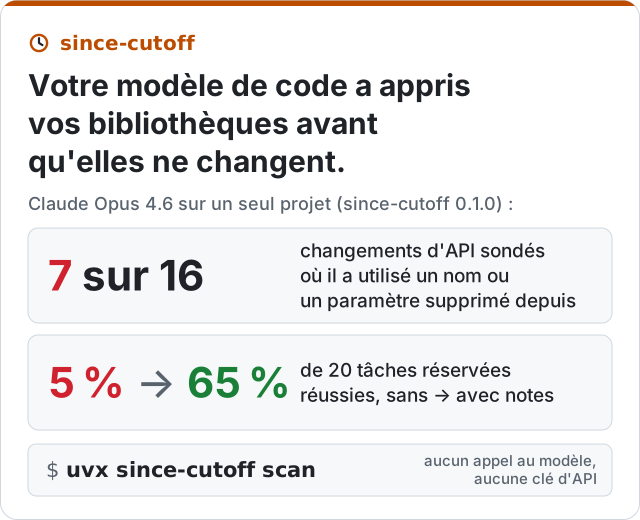
| changements d’API sondés | 20 | 16 |
| stale / wrong / deprecated / correct | 5 / 1 / 2 / 12 | 7 / 0 / 3 / 6 |
| bibliothèques avec des appels stale | 3 sur 5 sondées | 2 sur 4 sondées |
| notes rédigées (dont avec un exemple qui passe le vérificateur de types) | 8 (7), environ 391 jetons | 10 (7), environ 437 jetons |
| tâches réservées correctes, sans -> avec notes | 14 % -> 57 % (14 paires) | 5 % -> 65 % (20 paires) |
| API déjà correctes, une fois les notes ajoutées | 6/6 toujours correctes | 6/6 toujours correctes |
Dans cet échantillon, le modèle le plus puissant n’était pas plus sûr. Opus 4.6 a une date
limite plus tardive et a pourtant écrit du code périmé plus souvent :
anthropic.HUMAN_PROMPT avec client.completions, hf_hub_download(force_filename=...),
resume_download=....
D’autres exemples de code périmé tirés de l’exécution Haiku, chacun valide pour la version de comparaison et rejeté par le vérificateur de types dans la version épinglée :
client.messages.create(..., temperature=...): supprimé dans anthropic 1.8, qui lèveTypeErrorsi on le passehf_hub_download(..., resume_download=True),local_dir_use_symlinks=...etproxies=...: retirés de la signature depuis huggingface-hub 1.0 ; la 2.0 les accepte encore à l’exécution, les ignore et émet un avertissementclient.beta.vector_stores: une API d’openai 1.x que la 3.x a déplacée versclient.vector_stores
Une note suffit-elle ?
since-cutoff a rédigé 8 notes, environ 391 jetons, dont 7 avec un exemple qui passe le vérificateur de types (pour la huitième, l’outil s’est rabattu sur un simple constat tiré du diff d’API). Par exemple (texte original) :
**anthropic 1.8.0**
- `temperature=...` was removed from `messages.create()` in anthropic 1.8.0. Omit the `temperature` parameter entirely; there is no replacement.

**openai 3.19.2**
- `client.beta.vector_stores` is removed in openai 3.19.2. Use `client.vector_stores` instead.
Sur les tâches réservées des changements où il avait échoué, le modèle a répondu correctement dans 14 % des cas sans les notes et dans 57 % avec (14 tâches appariées, issues de 7 changements d’API). La carte de l’exécution indique aussi « 4 of 7 changes fixed, 95% CI 25-84% » : c’est le décompte de la 0.1.0, qui comptait aussi un changement comme corrigé quand une réponse réservée était déjà correcte sans les notes, et l’intervalle porte sur ce décompte, pas sur les deux taux. Les six API qu’il maîtrisait déjà sont restées correctes avec les notes dans son contexte.
Ce que ces chiffres disent, et ne disent pas
- Petit échantillon. Deux modèles, un projet, 16 à 20 sondes chacun. C’est la démonstration d’une méthode, pas un benchmark. L’intervalle de confiance est large parce que l’échantillon est petit.
- Un échantillon de changements, pas leur totalité. Les sondes sont classées (les API qu’utilise le code du projet d’abord, les incompatibilités franches avant les plus légères) ; le rédacteur de tâches ignore aussi les éléments internes.
- Ce qu’un vérificateur de types peut voir. Noms, paramètres et arité erronés, et dépréciations PEP 702. Les changements de comportement derrière une signature inchangée lui échappent.
- Les tâches réservées sont des reformulations du même changement : la comparaison avant/après mesure donc si une note corrige ce changement, pas une capacité générale.
- « La version de comparaison » découle d’une règle de date. Dans ces exécutions faites avec la 0.1.0, c’était la version la plus récente publiée au plus tard à la date limite. Les modèles connaissent mal les semaines qui précèdent immédiatement leur date limite, si bien que leurs connaissances peuvent être périmées plus tôt ; depuis la 0.6, c’est la dernière version publiée au moins 30 jours avant la date limite d’entraînement du modèle (par défaut).
Pourquoi ce sujet m’intéresse
Ce projet est né d’un article que j’ai coécrit pour EMNLP 2026 sur l’isolement temporel (temporal isolation) : utiliser la date limite d’entraînement d’un modèle comme une expérience naturelle sur ce qu’il sait. Les versions des bibliothèques relèvent de la même expérience, avec un bénéfice très concret : la réponse est une liste de lignes à mettre dans AGENTS.md.
Essayer
# les API modifiées qu'utilise votre code, avec une note pour chacune (aucun appel au modèle)
uvx since-cutoff scan

# écrire les notes dans AGENTS.md et les tenir à jour (aucun appel au modèle)
uvx since-cutoff sync

# facultatif : mesurer sur quels changements votre modèle se trompe, et tester les notes (appelle le modèle ;
# --with ajoute le vérificateur de types basedpyright, dont seul run a besoin)
uvx --with basedpyright since-cutoff run
run fonctionne avec Claude Code (sous forme de plugin), Anthropic, OpenAI, OpenRouter, DeepSeek,
Ollama et tout serveur compatible OpenAI ; scan, sync et status n’ont besoin que de la date
limite du modèle. sync --profile evaluated écrit les notes telles que le benchmark les a
mesurées (la portée importée, jusqu’à 5 API par paquet), et sync --header-only seulement leur
en-tête : les paquets modifiés et leurs versions. since-cutoff status (hors ligne), sync --check, les
hooks pre-commit
et une action GitHub
préviennent quand les notes ne sont plus à jour ; since-cutoff mcp permet à n’importe quel
client MCP (Claude Code, Codex, Cursor, VS Code, Gemini CLI) de consulter les changements d’une
bibliothèque avant d’écrire du code. Il ne prend en charge que Python pour l’instant ; TypeScript
est la prochaine étape. Vos retours sur la méthode sont les bienvenus dans les
issues, tout comme les résultats
obtenus sur vos propres projets dans
Share your results
(« Partagez vos résultats », en anglais). Si vous
souhaitez contribuer au code, les
good first issues
sont un bon point de départ.