
Mohammad Hijjawi · septiembre de 2026, actualizado en octubre de 2026 · since-cutoff en GitHub
since-cutoff es una herramienta de línea de comandos de código abierto y un servidor MCP para
proyectos de Python escritos con agentes de programación. scan muestra en qué lugares de tu
código se usa una API de una dependencia que cambió después de la fecha de corte de entrenamiento
del modelo, con una nota para cada una redactada a partir del diff de la API (la versión que
fijas frente a la versión de comparación, la más reciente publicada al menos 30 días antes de la
fecha de corte); sync escribe las notas en AGENTS.md o CLAUDE.md y las mantiene al día con tu
lockfile; status, los hooks de pre-commit y una GitHub Action te avisan cuando se quedan atrás;
el servidor MCP permite a un agente preguntar qué cambió en una biblioteca antes de escribir
código. Solo run, opcional, llama a un modelo: mide en cuáles de los cambios se equivoca y si
las notas ayudan. Cada nota lleva una etiqueta que dice qué se comprobó: redactada a partir del
diff de la API, o escrita por el modelo y conservada solo si su ejemplo pasa el verificador de
tipos para tu versión.
# las API modificadas que usa tu código, con una nota para cada una (sin llamadas al modelo, sin clave de API)
uvx since-cutoff scan

# escribir las notas en AGENTS.md y mantenerlas al día (sin llamadas al modelo)
uvx since-cutoff sync

# opcional: medir en qué cambios se equivoca el modelo y probar las notas (llama al modelo;
# --with añade el comprobador de tipos basedpyright, que solo necesita run)
uvx --with basedpyright since-cutoff run
pip install since-cutoff lo instala todo menos el comprobador de tipos de run;
pip install "since-cutoff[run]" lo añade (basedpyright, con el Node.js que trae).
Código fuente y documentación en GitHub · PyPI · Cómo funciona, en detalle (en inglés) · Solución de problemas (en inglés)
Qué hace, a partir de la 0.6
- Con qué versión compara. Para cada dependencia, la versión de comparación es la más
reciente publicada al menos 30 días antes de la fecha de corte de entrenamiento del modelo
(
--cutoff-margin DÍAS;0compara desde la propia fecha de corte, como antes de la 0.6). Un modelo conoce peor las últimas semanas antes de su fecha de corte: llama-index-core 0.13.0, que eliminóReActAgent.from_toolsyFunctionCallingAgent, se publicó el día antes de la fecha de corte de Claude Sonnet 4.5, y comparar desde la fecha de corte ocultaba las dos eliminaciones; con el margen, un proyecto que fija la 0.14.25 y llama a las dos recibe aviso de ambas. La línea del modelo, los informes y el bloque de notas dan las dos fechas, las tablas de dependencias titulan la columna «compared from», y el scan dice después de qué día cambiaron las API: «Your code uses 2 APIs that changed after 2025-07-01, 30 days before claude-sonnet-4-5’s training cutoff (2025-07-31)». - Dónde usa tu código una API que cambió. Importaciones y llamadas, y desde la 0.6 también
llamadas a métodos sobre objetos cuya clase el archivo nunca nombra: el tipo del receptor se
deduce de las anotaciones de la propia versión fijada, así que
df = pd.read_csv(...)es unDataFrame,df.groupby(...).count()unDataFrameGroupBy.count, yllm.predict(q)sobre unChatOpenAIesBaseChatModel.predictde langchain-core. Un cambio en un método heredado se detecta en las clases públicas que lo heredan (DataFrame.fillnaparaNDFrame.fillna). Un uso detectado solo por el nombre del método se omite salvo con--include-name-matches, y el scan dice cuántos omitió. - Qué ve el diff. Nombres eliminados o movidos, parámetros eliminados o que pasan a ser
obligatorios, cambios a solo palabra clave o solo posicionales, nuevas marcas de obsolescencia
(también el
@deprecatedde la PEP 702 importado a través de un módulo de compatibilidad) y cambios de dependencia (httpxporhttpx2). Novedades de la 0.6: los parámetros eliminados detrás de**kwargs: Unpack[UnTypedDict](read_csvde pandas 3.0 recibe así sus palabras clave y perdiódelim_whitespace,date_parser,infer_datetime_format,keep_date_colyverbose) y los nombres que un módulo toma de otra distribución confrom x import *(mcp.typesde mcp viene de mcp-types, que pasó todos sus campos a snake_case). - Cambios públicos e internos. Cada cambio es público (el nivel superior del paquete lo
exporta, un módulo lo nombra en
__all__, lo reexporta o lo documenta) o interno. Los recuentos dan los internos aparte, como «+N internal», yscan --internallos lista; las notas solo cubren las API que usa tu código. - Qué dicen las notas. El sustituto que nombra el propio texto de obsolescencia de la
biblioteca, con sus palabras, con la etiqueta
[diff + library](httpx 0.28: «Useproxyormountsinstead ofproxies»). El texto se busca donde lo ponen las bibliotecas: una directiva.. deprecated::, la entrada de un parámetro en el docstring, un mensaje dewarnings.warny, para un método eliminado sin texto propio, el de su clase (ReActAgent.from_toolsde llama-index-core: «Usellama_index.core.agent.workflow.ReActAgentinstead.»). Si el texto no nombra ninguno, la nota enlaza la guía de migración, el changelog o la página de versiones del paquete para los cambios desde la versión de comparación. Las citas conservan intacto el código de la biblioteca. Las viñetas que dicen lo mismo de varias API de un paquete se funden en una. Una dependencia publicada por primera vez después de la fecha de corte, o dentro del margen anterior, recibe una nota[metadata]con la fecha de su primera versión y su resumen. - Qué avisa que no pudo ver. Un módulo que la versión fijada distribuye compilado, sin
fuente
.pyni stub.pyi; una distribución reexportada que no se pudo descargar; una clase cuyos atributos puede definir una clase base de otro paquete; fuentes con una sintaxis que el Python que ejecuta since-cutoff no sabe analizar (el stub de numpy 2.5.4 en Python 3.10: el paquete no se pudo comprobar, y el scan nombra el Python que sí puede). El scan, el informe y las herramientas MCP avisan de cada caso en lugar de informar de eliminaciones que quizá no lo sean, o de ningún cambio. Un metapaquete como llama-index, sin API propia, se presenta como tal, con las partes que se comprobaron y las que no. Si no se puede acceder a PyPI, se usa una lista de versiones guardada en la caché hace más de 12 horas, y el scan dice de qué día es. - Dónde van las notas. AGENTS.md, CLAUDE.md o los dos: si existen ambos archivos y
CLAUDE.md no importa AGENTS.md (
@AGENTS.md),syncescribe el bloque en los dos, porque Claude Code solo lee CLAUDE.md y Codex, Cursor y Copilot leen AGENTS.md; y explica cómo quedarse con una sola copia. - Para scripts y agentes.
since-cutoff sync --json(con--yes,--checko--dry-run),since-cutoff models --json, ymodels --makerspara ver solo los listados de los fabricantes de los modelos, sin pasarelas ni revendedores. El servidor MCP tiene dos prompts,check_projectybefore_upgrade. Sin--model, el modelo de Gemini CLI se lee deGEMINI_MODELo de.gemini/settings.json. - Instalación, arranque y caché. basedpyright, que solo usa
run, es el extra[run]. Una instalación sin extras ocupó unos 73 MB de paquetes en un entorno virtual nuevo (unos 254 MB con[run]), ysince-cutoff --helparranca en unos 100 ms (ambas cifras medidas en Windows, con Python 3.13).since-cutoff cache infomuestra la caché por tipo,cache clear --sources,--diffso--pypivacía un tipo, ySINCE_CUTOFF_CACHE_MAX_MBlimita las fuentes extraídas (2048 por defecto).
Sigue siendo solo para Python, y las notas siguen saliendo de un diff estático de dos versiones: dicen qué cambió, no qué sabe el modelo. Los cambios de comportamiento que mantienen la misma firma no se ven.
El resto de esta página cuenta cómo surgió la herramienta y presenta las primeras mediciones, hechas con since-cutoff 0.1.0 en septiembre de 2026. Mediciones más recientes (en inglés): Lo que tu modelo no ha visto (36 bibliotecas, 21 modelos, sin llamadas al modelo, repetido con la 0.6) y el benchmark con un agente de programación (360 sesiones de Claude Code, con las notas de la 0.4.1).
Todo modelo de IA para programar tiene una fecha de corte de entrenamiento. Tu lockfile no. Cuando una biblioteca cambia su API pública después de esa fecha, un modelo que aprendió la versión anterior sigue escribiendo las llamadas antiguas, y nada en el prompt le indica lo contrario.
Quería una cifra en lugar de una anécdota: en un proyecto real, ¿con cuáles de las versiones exactas de dependencias que fija se equivoca el modelo, y basta una nota breve para corregir el error? since-cutoff es la herramienta que construí para responder a esa pregunta.
El experimento
El proyecto de ejemplo (examples/agent-app)
es una pequeña aplicación basada en agentes con nueve dependencias. Seis están fijadas en
versiones actuales (anthropic 1.8.0, openai 3.19.2, huggingface-hub 2.0.0, langchain-core 1.6.5,
langgraph 1.2.12 y pydantic 2.13.5); las otras tres no están fijadas (fastapi, requests y httpx),
así que la herramienta usa su versión más reciente.
Se evaluaron dos modelos: Claude Haiku 4.5 (fecha de corte de entrenamiento: febrero de 2025) y Claude Opus 4.6 (mayo de 2025). Las tareas y las notas las escribió Claude Opus 4.6.
Cómo mide
- Qué cambió. Para cada dependencia, se toma la versión de comparación, la versión más reciente publicada al menos 30 días antes de la fecha de corte de entrenamiento del modelo (por defecto; las ejecuciones con la 0.1.0 de más abajo tomaron la más reciente publicada en la fecha de corte o antes), y se compara su API pública con la versión fijada, de forma estática (con griffe, sin importar ningún módulo del paquete). Así se detectan objetos eliminados o movidos, parámetros eliminados o que pasan a ser obligatorios, parámetros que pasan a ser solo de palabra clave o solo posicionales, y nuevas marcas de obsolescencia. Para este proyecto y la fecha de corte de Claude Haiku 4.5, cambiaron 7 de las 9 dependencias; el diff de la 0.6, que compara desde el 29 de enero de 2025, señala 344 cambios incompatibles y 48 obsolescencias nuevas en API públicas, y 168 cambios en API internas.
- Tareas que requieren el cambio. Para los cambios de mayor prioridad, un modelo redactor de tareas genera tareas de programación breves y realistas que requieren la funcionalidad modificada, pero sin nombrar nunca el identificador que cambió ni su sustituto. Una tarea es el sondeo; las otras dos se reservan (held-out).
- Respuestas sin nada que consultar. El modelo recibe la tarea y el número de la versión fijada, sin herramientas, sin web y sin archivos del proyecto.
- Puntuación con un verificador de tipos, dos veces. La respuesta se verifica con
basedpyright frente a la versión de comparación (la del paso 1) y frente a la versión
fijada, cada una en un entorno aislado con sus propias dependencias. Solo cuentan los errores
de conocimiento de la API (nombres, importaciones y parámetros desconocidos, argumentos que
faltan, aridad), nunca los avisos del modo estricto de tipado.
- stale: válida para la versión de comparación, inválida para la fijada
- wrong: inválida, y no se explica por el cambio de versión
- deprecated: válida, pero usa una API marcada con
@deprecateden la versión fijada
- Escribir y probar las notas. Para cada fallo se escribe una nota de una línea para AGENTS.md. Una nota escrita por el modelo solo se conserva si su ejemplo pasa la verificación de tipos con la versión fijada y si todas las API que recomienda aparecen en ese ejemplo; si no, la nota es una descripción del cambio tomada directamente del diff de la API. Después, las tareas reservadas se responden de nuevo, sin las notas y con ellas, y se comparan por pares.
Nunca se ejecuta el código generado.
Resultados
Estas ejecuciones se hicieron con since-cutoff 0.1.0 y en un único proyecto, el descrito arriba.
| Claude Haiku 4.5 | Claude Opus 4.6 | |
|---|---|---|
| fecha de corte de entrenamiento | febrero de 2025 | mayo de 2025 |
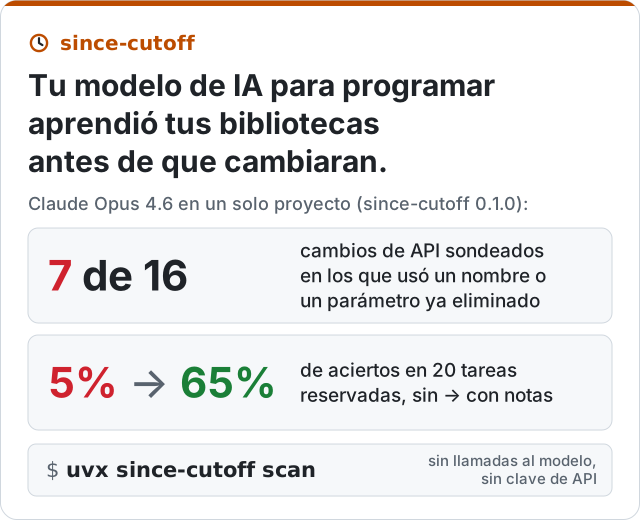
| cambios de API sondeados | 20 | 16 |
| stale / wrong / deprecated / correct | 5 / 1 / 2 / 12 | 7 / 0 / 3 / 6 |
| bibliotecas con uso desactualizado | 3 de 5 sondeadas | 2 de 4 sondeadas |
| notas escritas (con un ejemplo que pasa el verificador de tipos) | 8 (7), unos 391 tokens | 10 (7), unos 437 tokens |
| aciertos en tareas reservadas, sin -> con notas | 14% -> 57% (14 pares) | 5% -> 65% (20 pares) |
| API que el modelo ya usaba bien, con las notas | 6/6 siguen bien | 6/6 siguen bien |
En esta muestra, el modelo más potente no resultó más fiable. Opus 4.6 tiene una fecha de corte
posterior y, aun así, escribió código desactualizado con más frecuencia:
anthropic.HUMAN_PROMPT con client.completions, hf_hub_download(force_filename=...),
resume_download=....
Más código desactualizado de la ejecución con Haiku, en cada caso válido para la versión de comparación y rechazado por el verificador de tipos en la fijada:
client.messages.create(..., temperature=...): eliminado en anthropic 1.8, que lanzaTypeErrorsi se pasahf_hub_download(..., resume_download=True),local_dir_use_symlinks=...yproxies=...: fuera de la firma desde huggingface-hub 1.0; la 2.0 todavía los acepta en tiempo de ejecución, los ignora y emite un avisoclient.beta.vector_stores: una API de openai 1.x que la 3.x trasladó aclient.vector_stores
¿Lo corrige una nota?
since-cutoff escribió 8 notas, unos 391 tokens, 7 de ellas con un ejemplo que pasa el verificador de tipos (en un caso se recurrió a una simple afirmación extraída del diff de la API). Por ejemplo:
**anthropic 1.8.0**
- `temperature=...` was removed from `messages.create()` in anthropic 1.8.0. Omit the `temperature` parameter entirely; there is no replacement.

**openai 3.19.2**
- `client.beta.vector_stores` is removed in openai 3.19.2. Use `client.vector_stores` instead.
En las tareas reservadas de los cambios en los que había fallado, el modelo acertó en el 14 % sin las notas y en el 57 % con ellas (14 tareas emparejadas de 7 cambios de API). La tarjeta de la ejecución también indica «4 of 7 changes fixed, 95% CI 25-84%»: es el recuento de la versión 0.1.0, que también contaba un cambio como corregido cuando una respuesta reservada ya era correcta sin las notas, y el intervalo corresponde a ese recuento, no a las dos tasas. El modelo siguió usando bien, con las notas en su contexto, las seis API que ya acertaba.
Qué dicen y qué no dicen estas cifras
- Muestra pequeña. Dos modelos, un proyecto, 16-20 sondeos cada uno. Es la demostración de un método, no un benchmark. El intervalo de confianza es amplio porque la muestra es pequeña.
- Una muestra de los cambios, no todos. Los sondeos se ordenan por prioridad (primero las API que usa el propio código del proyecto, y los cambios que rompen el código antes que los más leves); el redactor de tareas también omite los elementos internos.
- Lo que puede ver un verificador de tipos. Nombres, parámetros y aridad incorrectos, y obsolescencias de la PEP 702. Los cambios de comportamiento que mantienen la misma firma son invisibles.
- Las tareas reservadas son paráfrasis sobre el mismo cambio, así que el antes y el después miden si una nota corrige ese cambio, no la capacidad general.
- «La versión de comparación» es una regla basada en fechas. En estas ejecuciones con la 0.1.0 era la versión más reciente publicada en la fecha de corte o antes. Los modelos conocen mal las semanas inmediatamente anteriores a su fecha de corte, así que la desactualización real puede empezar antes; desde la 0.6 es la versión más reciente publicada al menos 30 días antes de la fecha de corte de entrenamiento del modelo (por defecto).
Por qué me importa
Esto surgió de un artículo que coescribí para EMNLP 2026 sobre el aislamiento temporal (temporal isolation): usar la fecha de corte de entrenamiento de un modelo como experimento natural sobre lo que sabe. Las nuevas versiones de las bibliotecas son el mismo experimento, con una utilidad muy práctica: la respuesta es una lista de líneas para poner en AGENTS.md.
Pruébalo
# las API modificadas que usa tu código, con una nota para cada una (sin llamadas al modelo)
uvx since-cutoff scan

# escribir las notas en AGENTS.md y mantenerlas al día (sin llamadas al modelo)
uvx since-cutoff sync

# opcional: medir en qué cambios se equivoca el modelo y probar las notas (llama al modelo;
# --with añade el comprobador de tipos basedpyright, que solo necesita run)
uvx --with basedpyright since-cutoff run
run funciona con Claude Code (como plugin), Anthropic, OpenAI, OpenRouter, DeepSeek, Ollama y
cualquier servidor compatible con OpenAI; scan, sync y status solo necesitan la fecha de
corte del modelo. sync --profile evaluated escribe las notas como las midió el benchmark (el
alcance importado, hasta 5 API por paquete), y sync --header-only solo su encabezado: los
paquetes modificados y sus versiones. since-cutoff status (sin conexión), sync --check, los
hooks de pre-commit
y una GitHub Action
avisan cuando las notas se quedan atrás; since-cutoff mcp permite a cualquier cliente MCP
(Claude Code, Codex, Cursor, VS Code, Gemini CLI) consultar los cambios de una biblioteca antes de
escribir código. Por ahora solo admite Python; TypeScript es lo
siguiente. Los comentarios sobre el método son muy bienvenidos en los
issues, y los resultados de tus
propios proyectos, en
Share your results
(«Comparte tus resultados», en inglés). Si quieres
contribuir con código, los
good first issues
son un buen punto de partida.